Träningsdata
Vad är Träningsdata?
Träningsdata är den samling av befintligt innehåll, som bilder, videor, text eller ljud, som en AI-modell exponeras för under inlärningsprocessen. För språkmodeller som ChatGPT och Claude består den till stor del av text, som webbsidor, böcker och artiklar. Modellen sparar inte en kopia av datan att slå upp i. Den justerar i stället sina inre inställningar, en enorm mängd små tal, steg för steg tills den blir bra på att förutsäga mönstren i datan. Det liknar att lära sig ett språk genom att läsa mycket: du minns inte varje mening, men du får en känsla för hur språket fungerar.
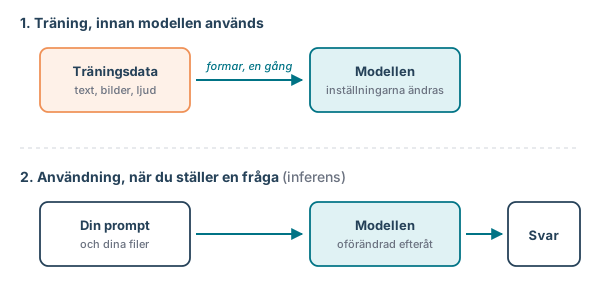
Träningsdata är inte samma sak som det du själv ger modellen när du använder den, det som kallas inferens. Din prompt och dina uppladdade filer påverkar svaret just då, men ändrar inte modellen. Kunskapen om hur just ditt bageri hanterar sina beställningar finns inte i träningsdatan, den måste du ge modellen själv.
Kvaliteten och mångfalden i träningsdatan avgör hur väl och pålitligt modellen kan utföra sina uppgifter. Principen brukar sammanfattas som 'garbage in, garbage out': är datan skev, ofullständig eller felaktig blir modellen det också. Ett klassiskt exempel är medicinsk AI som tränats främst på data från män och därför missar symptom hos kvinnor, eller ansiktsigenkänning som fungerar sämre på mörkhyade ansikten när träningsdatan domineras av ljushyade.
Ursprung och källa
Allmänt använd sedan 1950-talet
Se även
Läs mer

Nu kan du det här ordet.
Hur många fler har du koll på? Spela Ordkollen →